
Ollama e escrita offline
Conecte um modelo local e prepare um fluxo de trabalho de escrita que você pode usar sem conexão de rede.
O Ollama executa no seu computador os modelos que você baixa. Conecte-o ao Oleafly para usar IA local junto do seu manuscrito. Prepare o modelo e as dependências do documento enquanto você tem conexão e depois teste o fluxo de trabalho que pretende usar offline.
Instale e inicie o Ollama
Seção intitulada “Instale e inicie o Ollama”Instale o Ollama pela página oficial de download (abre em uma nova guia). Abra o Ollama, ou inicie o servidor local dele em um terminal:
ollama serveSe o Ollama já estiver em execução, use esse servidor existente. Baixe um modelo que caiba no seu computador. Por exemplo:
ollama pull qwen3:8bollama listO primeiro comando baixa um modelo; o segundo lista os modelos locais. O tamanho do modelo, a memória disponível e o comprimento do contexto afetam a velocidade. A documentação (abre em uma nova guia) do Ollama descreve os modelos com suporte e a configuração do sistema.
Procurar o Ollama
Seção intitulada “Procurar o Ollama”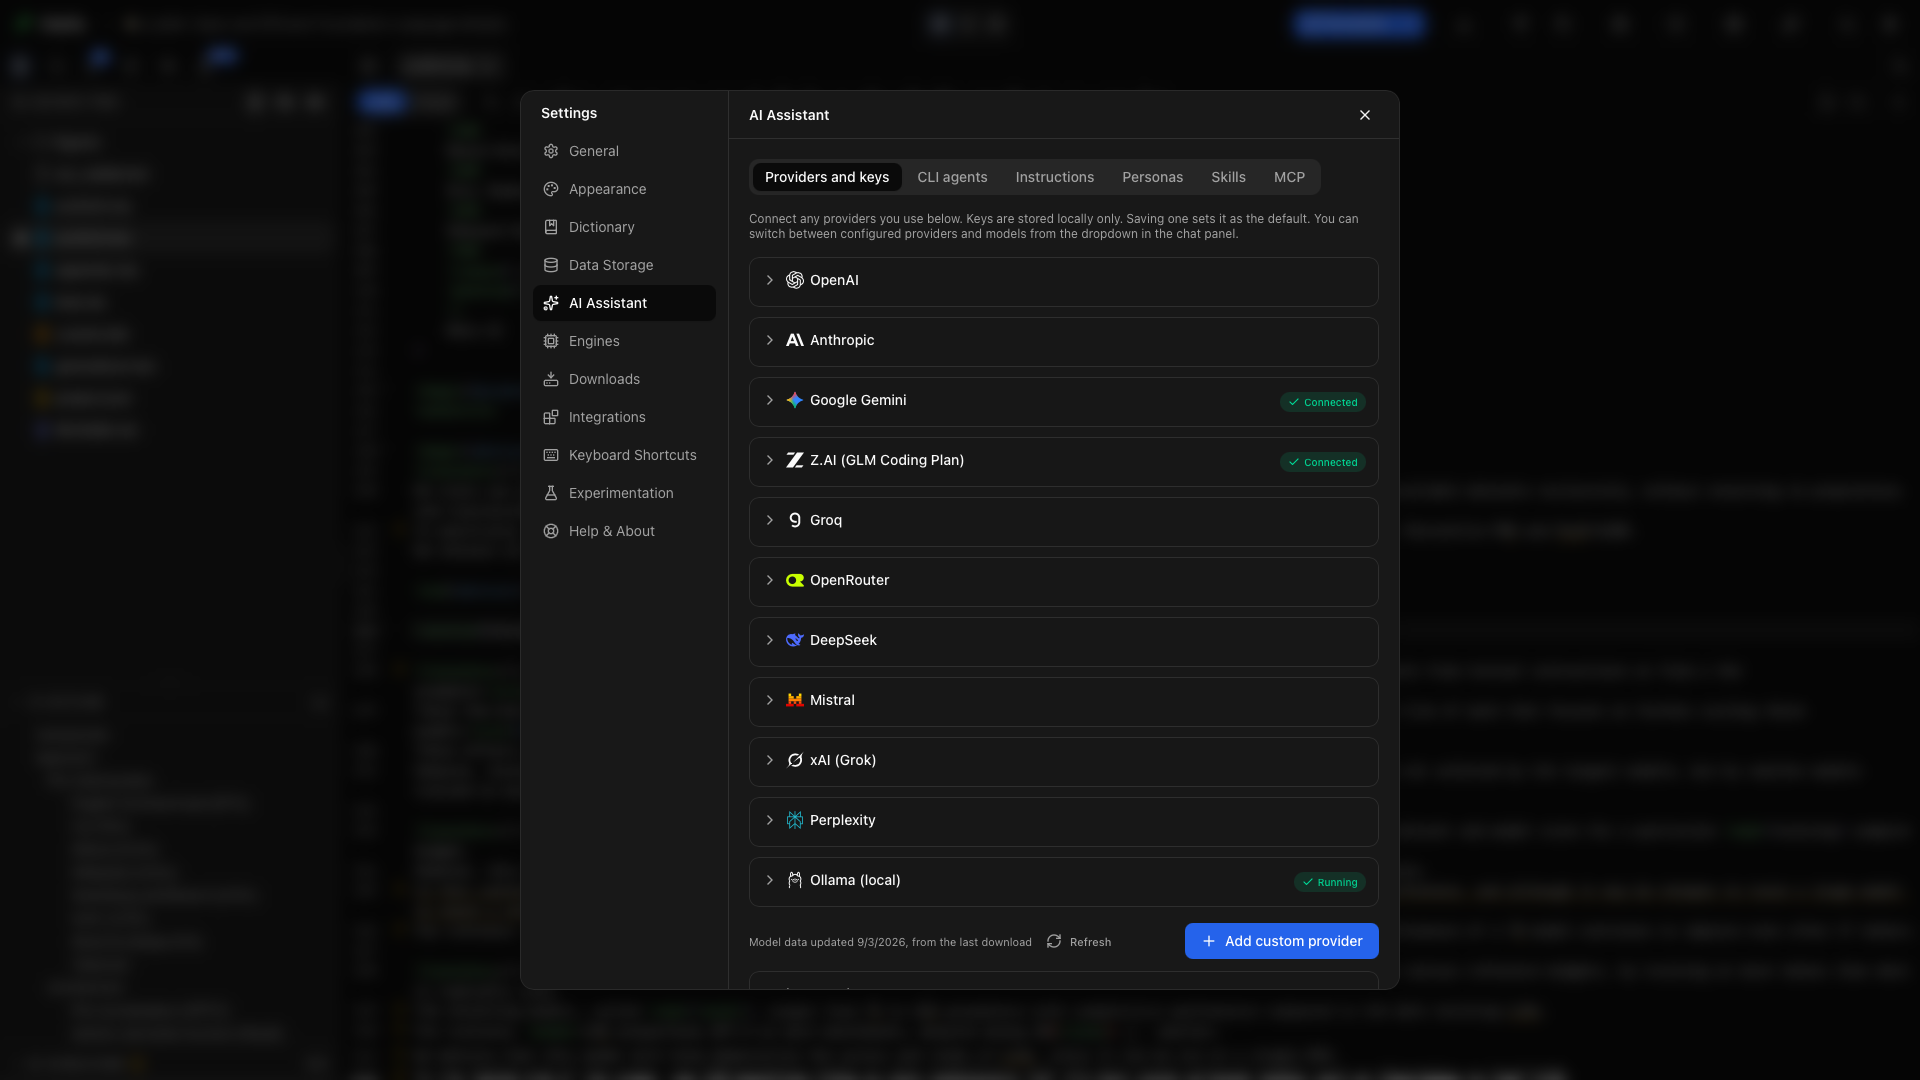
- Abra Configurações → Assistente de IA → Provedores e chaves.
- Expanda Ollama.
- Escolha Procurar o Ollama.
- Inspecione o status e a lista de modelos instalados.
Se o aplicativo encontrar um Ollama instalado, mas parado, Iniciar o Ollama o inicia. Escolha Verificar de novo depois que o servidor iniciar ou depois de baixar outro modelo.
Escolha um modelo local
Seção intitulada “Escolha um modelo local”Selecione um modelo da lista detectada e use a ação do cartão para aplicá-lo. Abra o assistente e confirme que o modelo local está selecionado antes de enviar uma mensagem.
Experimente com um documento de prática:
Explique a estrutura deste documento. Liste as seções dele sem alterar nenhum arquivo.
Para edições ou compilação, use um modelo que ofereça suporte ao comportamento de ferramentas de que o Oleafly precisa. Verifique o resultado de capacidades do modelo; um modelo que sabe conversar não é automaticamente capaz de executar um fluxo de trabalho de ferramentas confiável.
Mudar o host
Seção intitulada “Mudar o host”Escolha Mudar o host (avançado) para editar o endereço do servidor do Ollama. O host local usual é http://127.0.0.1:11434. Use o cartão interno do Ollama com o host do servidor; o sufixo /v1 pertence a uma configuração de endpoint compatível com OpenAI.
Um servidor em execução em outro computador é uma conexão de rede. Use o endereço de loopback local quando quiser que o processamento fique neste computador.
Use um provedor compatível no lugar
Seção intitulada “Use um provedor compatível no lugar”Para uma conexão personalizada compatível com OpenAI, use o endpoint do Ollama http://localhost:11434/v1/. O Ollama aceita o campo de chave de API exigido pelo cliente de compatibilidade sem tratá-lo como uma credencial de nuvem. Veja o guia de compatibilidade do Ollama (abre em uma nova guia) e provedores personalizados.
Prepare a compilação offline
Seção intitulada “Prepare a compilação offline”Abra o documento e compile com sucesso enquanto estiver conectado. O Tectonic baixa os pacotes TeX que faltam conforme necessário e os coloca em cache, e o Typst faz o mesmo com pacotes do Typst Universe. Depois ative Configurações → Geral → Modo offline e compile de novo para verificar se o cache é suficiente. O modo offline cobre LaTeX e Typst.
Um projeto Typst também pode manter os próprios pacotes. Abra Pacotes Typst na barra de ferramentas do Typst e escolha Incorporar os pacotes ao projeto. O Oleafly copia os pacotes que o projeto importa para uma pasta typst-packages, então o projeto compila offline e em outros computadores.
Para um motor TeX do sistema, instale a distribuição e os pacotes necessários antes de se desconectar. Mantenha imagens, arquivos de bibliografia, seções incluídas e fontes necessárias disponíveis localmente.
Teste sem conexão de rede
Seção intitulada “Teste sem conexão de rede”- Abra o projeto que você vai usar.
- Confirme que o Ollama está em execução com o modelo baixado selecionado.
- Desconecte-se da rede.
- Compile o documento.
- Peça ao modelo local para explicar um parágrafo.
- Experimente a edição ou o fluxo de ferramentas específico de que você precisa e inspecione o resultado.
Escrita, arquivos locais, compilação em cache e requisições a modelos locais podem continuar. A descoberta de fontes on-line, a sincronização com o GitHub, os modelos de nuvem e os serviços MCP de rede precisam das próprias conexões. O Modo offline do Oleafly controla a compilação em cache e as buscas de citações; ele não é um firewall de rede para todo o sistema.
Desconectar o Ollama
Seção intitulada “Desconectar o Ollama”Use Desconectar no cartão do provedor para remover a conexão salva do Oleafly. Isso não exclui os modelos instalados no Ollama.
Solução de problemas
Seção intitulada “Solução de problemas”Não está em execução
Seção intitulada “Não está em execução”Inicie o Ollama, confirme o host e a porta e então use Verificar de novo. Se o servidor informar que a porta já está em uso, inspecione a instância existente antes de iniciar outra.
Nenhum modelo instalado
Seção intitulada “Nenhum modelo instalado”Execute ollama list. Baixe um modelo, espere o download terminar e use Verificar de novo no Oleafly.
O modelo responde, mas não usa ferramentas
Seção intitulada “O modelo responde, mas não usa ferramentas”Inspecione o estado de capacidades dele e experimente um modelo com suporte a ferramentas. Comece com uma requisição pequena que lê o projeto antes de pedir uma sequência longa de edição e compilação.
A resposta não tem nada a ver com a pergunta
Seção intitulada “A resposta não tem nada a ver com a pergunta”O contexto do modelo provavelmente é pequeno demais. As instruções de projeto e as ferramentas do Oleafly ocupam espaço antes da sua mensagem, e um contexto de 4.096 tokens pode cortar até uma requisição curta. Inicie o servidor do Ollama com pelo menos 16.384 tokens de contexto, por exemplo:
OLLAMA_CONTEXT_LENGTH=16384 ollama serveNo Windows PowerShell, execute $env:OLLAMA_CONTEXT_LENGTH = "16384" e depois ollama serve. Encerre antes qualquer Ollama em execução. A configuração pertence ao servidor do Ollama, não ao Oleafly. Conversas mais longas e projetos maiores precisam de mais contexto, e mais contexto usa mais memória. O guia de comprimento de contexto (abre em uma nova guia) do Ollama tem os detalhes.
A resposta local é lenta
Seção intitulada “A resposta local é lenta”Experimente um modelo menor ou uma requisição mais curta e focada. Anexe o arquivo ou a seção relevante em vez de pedir de uma vez a revisão de uma tese inteira.